모델과 weight 개수 세기 ★★
교수님 예시 모델은 층(layer)이 3개예요. 입력 5개가 층을 지나며 6개 → 3개 → 1개로 줄어들어서 마지막에 예측값 ŷ 하나가 나와요. 각 층에는 곱해지는 숫자 모음, 즉 weight(가중치)가 있어요.
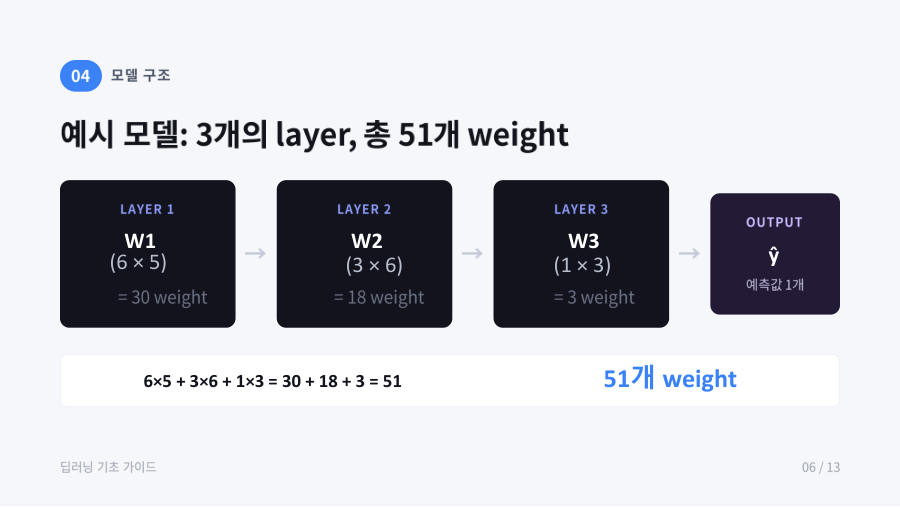
| 층 | weight 모양 (출력×입력) | 개수 계산 |
|---|---|---|
| 1층 W1 | 6 × 5 | 5개를 받아 6개를 냄 → 30개 |
| 2층 W2 | 3 × 6 | 6개를 받아 3개를 냄 → 18개 |
| 3층 W3 | 1 × 3 | 3개를 받아 1개를 냄 → 3개 |
| 합계 | 30 + 18 + 3 = 51개 |
weight 모양은 "(나가는 개수) × (들어오는 개수)"로 쓰고, 개수는 두 수를 곱하면 돼요. 교수님은 "바이어스를 제외한 숫자"라고 했어요. bias(편향)는 곱한 값에 더해지는 숫자로, 층마다 출력 개수만큼 있어요. 참고로 bias까지 세면 (30+6) + (18+3) + (3+1) = 61개예요.
weight와 bias처럼 학습으로 값이 바뀌는 숫자 전체를 파라미터(parameter)라고 불러요. 층 하나를 만드는 nn.Linear(입력 개수, 출력 개수)의 파라미터 수는 출력×입력(weight) + 출력(bias)예요. 예를 들어 nn.Linear(3, 2)는 6 + 2 = 8개예요(교수님 설명).
처음 값은 어떻게 정할까요? 정답을 아직 모르니까 51개를 랜덤(무작위)으로 채워서 시작해요(torch.randn(...)). 그래서 처음 예측이 틀리는 건 당연해요. 학습이 이 숫자들을 고쳐 나가요.
weight 개수는 층마다 (출력 × 입력)을 계산해 더한다. 학습 시작 시 weight는 랜덤하게 초기화되므로 첫 예측은 대부분 틀린다. nn.Linear(in, out)의 파라미터 수 = out×in + out. 선택지에 개수가 나오면 층별로 곱해서 더해 보세요.
잠깐 확인 — nn.Linear(4, 3)의 파라미터는 모두 몇 개인가요?
weight 3×4 = 12개, bias 3개라서 15개예요.
자료: 4주차 · 딥러닝 모델 Training 과정.pdf, Week04 Autograd_Loss_Optimizer.ipynb · 빅데이터04(4주차) 녹취, 빅데이터03·07 녹취 일부