가장 쉬운 한 층 모델 — x @ W.T + B ★★★
딥러닝에서 한 층(layer)은 "입력 숫자 여러 개를 섞어서 출력 숫자 여러 개로 바꾸는 계산"이에요. 용어부터 풀어 볼게요.
- 특성(feature) : 입력 숫자 하나하나예요. 학생 정보라면 중간고사 점수, 공부 시간 같은 것이에요.
- 배치(batch) : 한 번에 넣는 데이터 묶음이에요. 학생 4명을 한꺼번에 넣으면 배치 크기는 4예요.
- 가중치(weight, W) : 각 입력에 곱하는 "중요도 점수"예요.
- 편향(bias, B) : 마지막에 더하는 "기본 점수"예요.
성적 환산과 같아요. "국어 × 0.3 + 영어 × 0.3 + 수학 × 0.4 + 가산점 5점"처럼, 각 점수에 반영 비율(W)을 곱해서 더하고 마지막에 가산점(B)을 더해요. 딥러닝은 이 비율과 가산점을 학습으로 찾아내요.
3주차 업데이트본에서 교수님은 이 계산을 nn.Linear 없이 직접 써서 보여 줬어요. "nn.Linear가 바로 나오면 점프가 크다"는 질문이 많았기 때문이에요. 먼저 숫자를 직접 정한 모델을 볼게요.
실행 결과는 아래와 같아요.
| 코드 줄 | 무슨 뜻 |
|---|---|
self.W = torch.tensor([[1,0,2],[0,1,1]]) | 가중치 W. 2줄 × 3칸이라 크기가 (2, 3)이에요. 한 줄이 출력 하나를 만드는 비율표예요. |
self.B = torch.tensor([0.5, -1.0]) | 편향 B. 출력이 2개라서 숫자 2개예요. |
x @ self.W.T | @는 행렬 곱셈이에요. .T는 W의 가로세로를 뒤집은 것(전치)이라서 (3, 2)가 돼요. |
+ self.B | 결과의 모든 줄에 B를 똑같이 더해요. 작은 것을 알아서 늘려 맞추는 것을 브로드캐스팅(broadcasting)이라고 해요. |
y = model(x) | x를 모델에 넣어 예측 y를 얻어요. 크기는 (4, 2)예요. |
첫 번째 학생 [1, 2, 3]을 손으로 계산해 볼게요.
- 첫 번째 출력 = 1×1 + 0×2 + 2×3 + 0.5 = 7.5
- 두 번째 출력 = 0×1 + 1×2 + 1×3 − 1 = 4.0
W의 첫 줄 [1, 0, 2]가 첫 번째 출력을 만드는 비율표이고, 둘째 줄 [0, 1, 1]이 두 번째 출력의 비율표예요. 나머지 3명도 같은 방식이에요.
| 이름 | 크기 | 설명 |
|---|---|---|
| 입력 x | (4, 3) | 데이터 4개, 각각 특성 3개 |
| 가중치 W | (2, 3) | (출력 개수, 입력 개수) |
| 뒤집은 W.T | (3, 2) | 곱셈을 맞추려고 뒤집어요 |
| 편향 B | (2,) | 출력 개수만큼 |
| 출력 y | (4, 2) | 데이터 4개, 각각 출력 2개 |
(m, k) @ (k, n) = (m, n). 안쪽 숫자(k)가 같아야 곱할 수 있고, 바깥 숫자 둘이 결과의 크기가 돼요. W를 (출력, 입력)으로 만들고 .T로 뒤집는 이유가 바로 이 규칙 때문이에요.
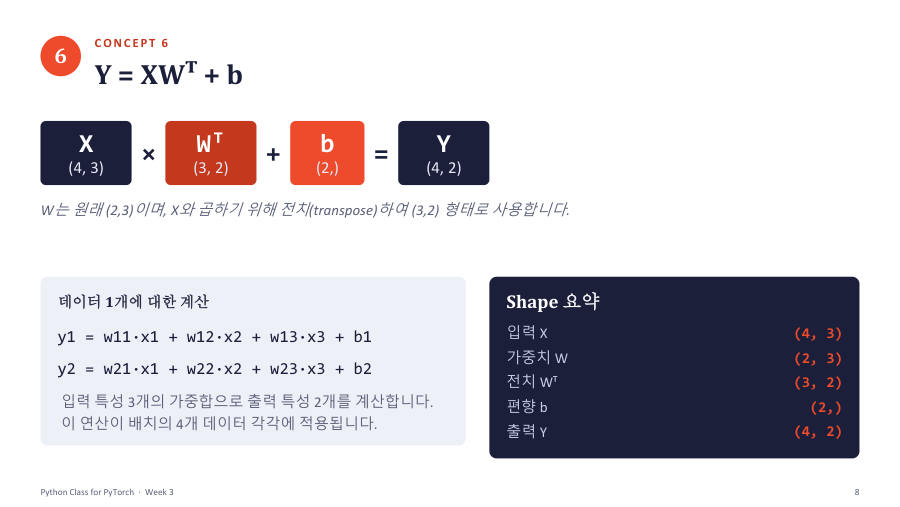
"입력 특성 3개를 출력 특성 2개로 바꾼다"는 문장이 있으면 W는 (2, 3), B는 (2,), 출력은 (배치 크기, 2)예요. 숫자를 외우지 말고 "W는 (출력, 입력)"만 기억하세요. 입력의 마지막 숫자(특성 개수)가 W의 두 번째 숫자와 같지 않으면 곱셈이 안 돼서 오류가 나요.
잠깐 확인 — 입력 x가 (5, 4)이고 입력 특성 4개를 출력 3개로 바꾸는 모델이면 W와 y의 크기는?
W는 (3, 4), B는 (3,), 출력 y는 (5, 3)이에요. (5, 4) @ (4, 3) = (5, 3)이 되고 B가 5줄에 똑같이 더해져요.
자료: 3·6주차 · Week03_Class_for_PyTorch(업데이트), Week04_Autograd_Loss_Optimizer · 6주차 녹취(빅데이터06), 7주차 녹취(빅데이터07)