← 보드손실 함수와 옵티마이저 · 4/7
backward()는 계산, step()은 갱신 — 역할 분담 ★★★
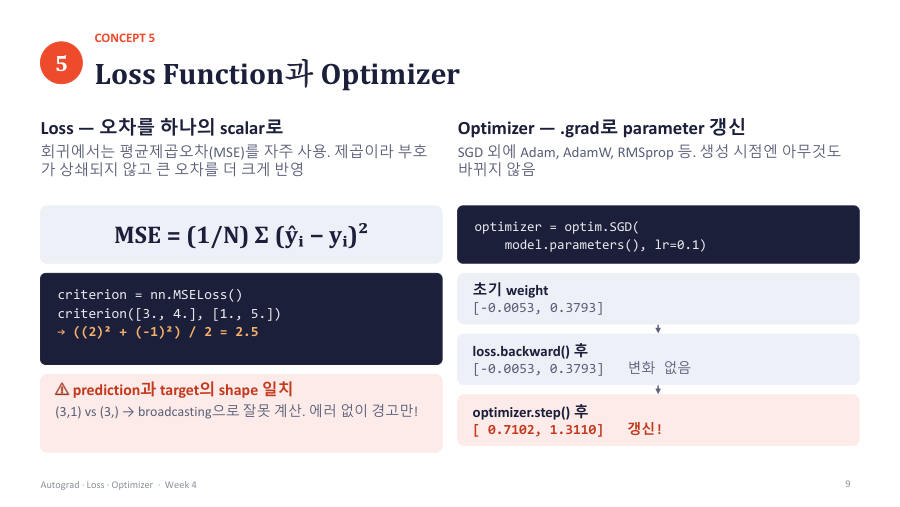
샘플 시험 5번의 핵심이에요. 두 함수는 하는 일이 완전히 달라요. 값이 어떻게 바뀌는지 직접 보면 가장 확실해요. 교수님 자료의 기본 실습 5번이에요. 가중치 1.0짜리 모델에 입력 2, 정답 4를 넣고 학습률 0.1로 한 번 학습해요.
model = nn.Linear(1, 1, bias=False)
with torch.no_grad():
model.weight.fill_(1.0) # weight를 1.0으로 고정
X = torch.tensor([[2.0]])
target = torch.tensor([[4.0]])
criterion = nn.MSELoss()
optimizer = optim.SGD(model.parameters(), lr=0.1)
optimizer.zero_grad()
prediction = model(X)
loss = criterion(prediction, target)
print("업데이트 전 weight:", model.weight.item())
print("업데이트 전 loss:", loss.item())
loss.backward()
print("backward 직후 weight:", model.weight.item())
print("weight.grad:", model.weight.grad.item())
optimizer.step()
print("step 직후 weight:", round(model.weight.item(), 2))
print("업데이트 후 loss:", round(criterion(model(X), target).item(), 2))
업데이트 전 weight: 1.0
업데이트 전 loss: 4.0
backward 직후 weight: 1.0
weight.grad: -8.0
step 직후 weight: 1.8
업데이트 후 loss: 0.16
| 코드 줄 | 무슨 뜻 |
|---|---|
nn.Linear(1, 1, bias=False) | 입력 1개, 출력 1개, 편향 없음. 학습할 숫자는 weight 하나뿐이에요. |
model.weight.fill_(1.0) | weight를 1.0으로 채워요. 손으로 풀기 쉽게 정한 값이에요. |
prediction = model(X) | 1.0 × 2 = 2 |
loss = criterion(...) | (2 − 4)² = 4 |
loss.backward() | 기울기를 계산해요. 2 × (2 − 4) × 2 = −8. 하지만 weight는 아직 1.0 그대로예요. |
optimizer.step() | 저장된 기울기로 갱신해요. 1.0 − 0.1 × (−8) = 1.8 |
| 업데이트 후 loss | 예측 1.8 × 2 = 3.6, 오차 (3.6 − 4)² = 0.16. 4에서 0.16으로 줄었어요. |
세 줄을 따로 보면 이렇게 나눠져요.
| 함수 | 하는 일 | weight 값은? |
|---|---|---|
optimizer.zero_grad() | 저장된 기울기를 지워요 (비워요) | 안 바뀌어요 |
loss.backward() | 기울기를 계산해서 .grad에 저장해요 | 안 바뀌어요 |
optimizer.step() | 저장된 기울기로 파라미터를 갱신해요 | 여기서 바뀌어요 |
step()은 기울기를 새로 계산하지도, 지우지도 않아요. 이미 저장된 .grad를 읽어 값을 고치기만 해요. 그래서 step() 전에 backward()가 꼭 있어야 하고, 다음 반복 전에는 기울기를 지워 줘야 해요. (참고로 요즘 PyTorch는 zero_grad()가 기울기를 0 대신 "없음(None)"으로 비워요. 지워서 새로 시작한다는 의미는 같아요.)
이렇게 고르세요 (풀이 요령)
샘플 5번 보기를 이 표로 하나씩 지워 보세요. "optimizer.step()은 저장된 기울기를 이용해 파라미터를 갱신한다"가 맞아요. "loss.backward()가 파라미터 값까지 갱신한다", "zero_grad()가 파라미터를 0으로 만든다", "criterion이 이전 기울기를 초기화한다", "step()이 기울기를 새로 계산한다"는 모두 틀려요. 계산은 backward, 갱신은 step, 비우기는 zero_grad, 점수 매기기는 criterion이에요.
잠깐 확인 — loss.backward() 직후와 optimizer.step() 직후 중 weight 값이 바뀌는 시점은?
optimizer.step() 직후예요. backward 직후에는 기울기(.grad)만 채워지고 weight는 그대로예요.
다음 카드 → 학습률(learning rate) — 한 걸음의 크기 ★★
자료: 6·7주차 · Week04_Autograd_Loss_Optimizer · 7주차 녹취(빅데이터07)