시험공부빅데이터분석
← 보드학습 루프와 검증 · 3/7

배치로 나눠 학습하기 — 반복문 안의 반복문 ★★★

데이터가 많으면 8장의 DataLoader로 배치를 만들어서 쓰고, 5줄을 배치마다 실행해요. 그래서 반복문이 2겹이 돼요. 바깥은 epoch, 안쪽은 배치예요.

for epoch in range(30) (데이터 전체 한 바퀴를 30번) for batch_x, batch_y in train_loader (배치 5개를 하나씩) 1 지우기zero_grad 2 예측model(x) 3 채점criterion 4 기울기backward 5 갱신step 배치 하나마다 5줄을 실행해요 (= step 1번) step 횟수 = 배치 수 × epoch 수 = 5 × 30 = 150번 sample 90개, batch_size 20이면 배치는 5개(20, 20, 20, 20, 10)

교수님 노트북의 코드예요. sample 90개를 배치 20개씩 묶어서 30 epoch 학습해요.

torch.manual_seed(0) # 난수를 고정해서 매번 같은 결과가 나오게 해요 x_train = torch.linspace(-2.0, 2.0, steps=90).reshape(-1, 1) y_train = 2 * x_train + 1 train_dataset = TensorDataset(x_train, y_train) train_loader = DataLoader(train_dataset, batch_size=20, shuffle=True, drop_last=False) class MyModel(nn.Module): def __init__(self): super().__init__() self.fc = nn.Linear(1, 1) def forward(self, x): return self.fc(x) model = MyModel() criterion = nn.MSELoss() optimizer = optim.SGD(model.parameters(), lr=0.02) for epoch in range(30): total_loss = 0.0 total_samples = 0 for batch_x, batch_y in train_loader: optimizer.zero_grad() prediction = model(batch_x) loss = criterion(prediction, batch_y) loss.backward() optimizer.step() batch_samples = batch_x.size(0) total_loss += loss.item() * batch_samples total_samples += batch_samples epoch_loss = total_loss / total_samples print(f"epoch={epoch+1} 평균 loss={epoch_loss:.6f} " f"w={model.fc.weight.item():.4f} b={model.fc.bias.item():.4f}")
epoch=1 평균 loss=4.750661 w=0.4857 b=0.6444 epoch=2 평균 loss=2.711969 w=0.8489 b=0.7055 epoch=3 평균 loss=1.574250 w=1.1350 b=0.7765 ... epoch=10 평균 loss=0.032139 w=1.8791 b=0.9484 ... epoch=30 평균 loss=0.000001 w=1.9996 b=0.9992
코드 줄무슨 뜻
torch.manual_seed(0)랜덤 값을 고정해요. 그래서 처음 weight와 섞는 순서가 같아져 아래 출력과 똑같은 결과를 얻어요.
torch.linspace(-2.0, 2.0, steps=90)-2부터 2까지 같은 간격으로 90개 숫자를 만들어요. sample 90개예요.
TensorDataset(x_train, y_train)입력과 정답을 짝지어 Dataset으로 만들어요. (8장)
DataLoader(..., batch_size=20, shuffle=True)20개씩 묶고 epoch마다 섞어요. 90 ÷ 20 = 4.5이니 배치는 5개(20, 20, 20, 20, 10)예요.
self.fc = nn.Linear(1, 1)5장의 모델 클래스예요. 층 한 개를 가져요.
for epoch in range(30):바깥 반복. 데이터 전체를 30번 돌아요.
for batch_x, batch_y in train_loader:안쪽 반복. 이 for 문 한 번을 끝까지 돌면 1 epoch이에요. 한 epoch에 5번 돌아요.
5줄배치마다 실행돼요. 그러니 weight는 한 epoch에 5번 업데이트돼요.
total_loss, total_samplesepoch의 loss 합계와 사용한 sample 수를 모아요. 다음 절에서 설명해요.

weight가 업데이트되는 횟수를 세 보면 5 × 30 = 150번이에요. 데이터를 한꺼번에 넣었던 앞 예제(1 epoch에 1번)와 달라요. 한 epoch 안에서 업데이트가 여러 번 일어난다는 점이 다른 거예요. 결과도 30 epoch 만에 w가 2에, b가 1에 매우 가까워졌어요. 교수님 자료에서는 weight가 한 번 업데이트될 때마다 1 iteration이라고 해요(여기서 말하는 step과 같은 뜻이에요). 전체 데이터를 한 바퀴 쓰면 1 epoch이에요.
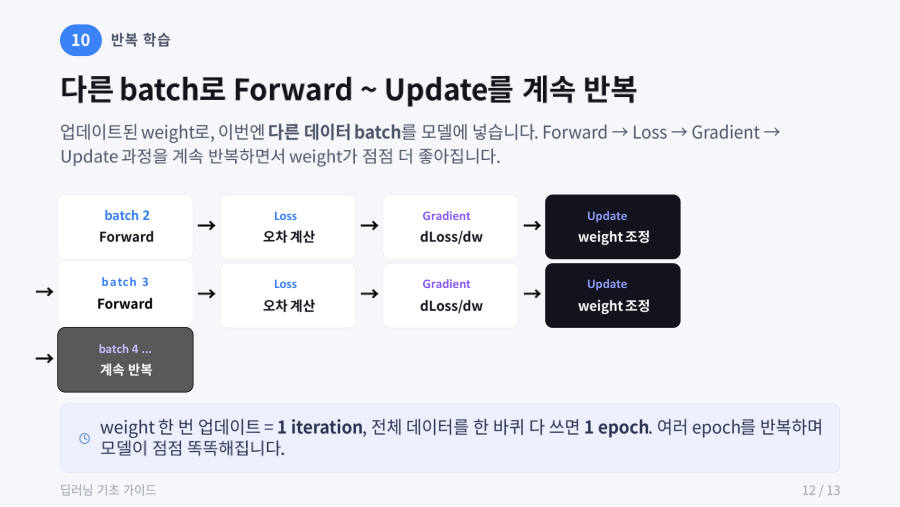
반복 학습
교수님 슬라이드 — 다른 batch로 Forward ~ Update를 계속 반복, weight 한 번 업데이트 = 1 iteration, 한 바퀴 = 1 epoch
이렇게 고르세요 (풀이 요령)

step 횟수 문제는 "한 epoch의 배치 수 × epoch 수"로 풀어요. sample 90개, batch_size 20, 30 epoch이면 5 × 30 = 150이에요. 배치 수는 8장처럼 올림(4.5 → 5)이에요. 또 "for batch_x, batch_y in loader 안에 5줄이 있다"는 보기는 배치마다 업데이트한다는 뜻이에요.

잠깐 확인 — sample 100개, batch_size 25, 10 epoch이면 weight는 모두 몇 번 업데이트될까요?

배치 수 4(100 ÷ 25) × 10 = 40번이에요.

다음 카드 → epoch 평균 loss — 마지막 배치가 작을 때 ★★

자료: 6·7주차 · Week04_Autograd_Loss_Optimizer, Week05_Dataset_DataLoader_Train_Validation(part1), 딥러닝 모델 Training 과정.pdf · 7주차 녹취(빅데이터07)